実践MCP―ファイルを整理するAIエージェントを作る
はじめに
LLMは質問に答えることはできますが、フォルダを読む方法や社内APIを呼び出す方法まで自分で知っているわけではありません。機能を1つ増やすたびに、ツールの内容を説明し、入力を検証し、実際のシステムを呼び出し、その結果を会話へ戻すための統合ポイントが必要になります。しかも、AIアプリケーションごとに各システムへ個別につないでいくと、n個のアプリケーションとm個のシステムから、書いて保守すべきアダプタは最大で n × m 個にもなります。
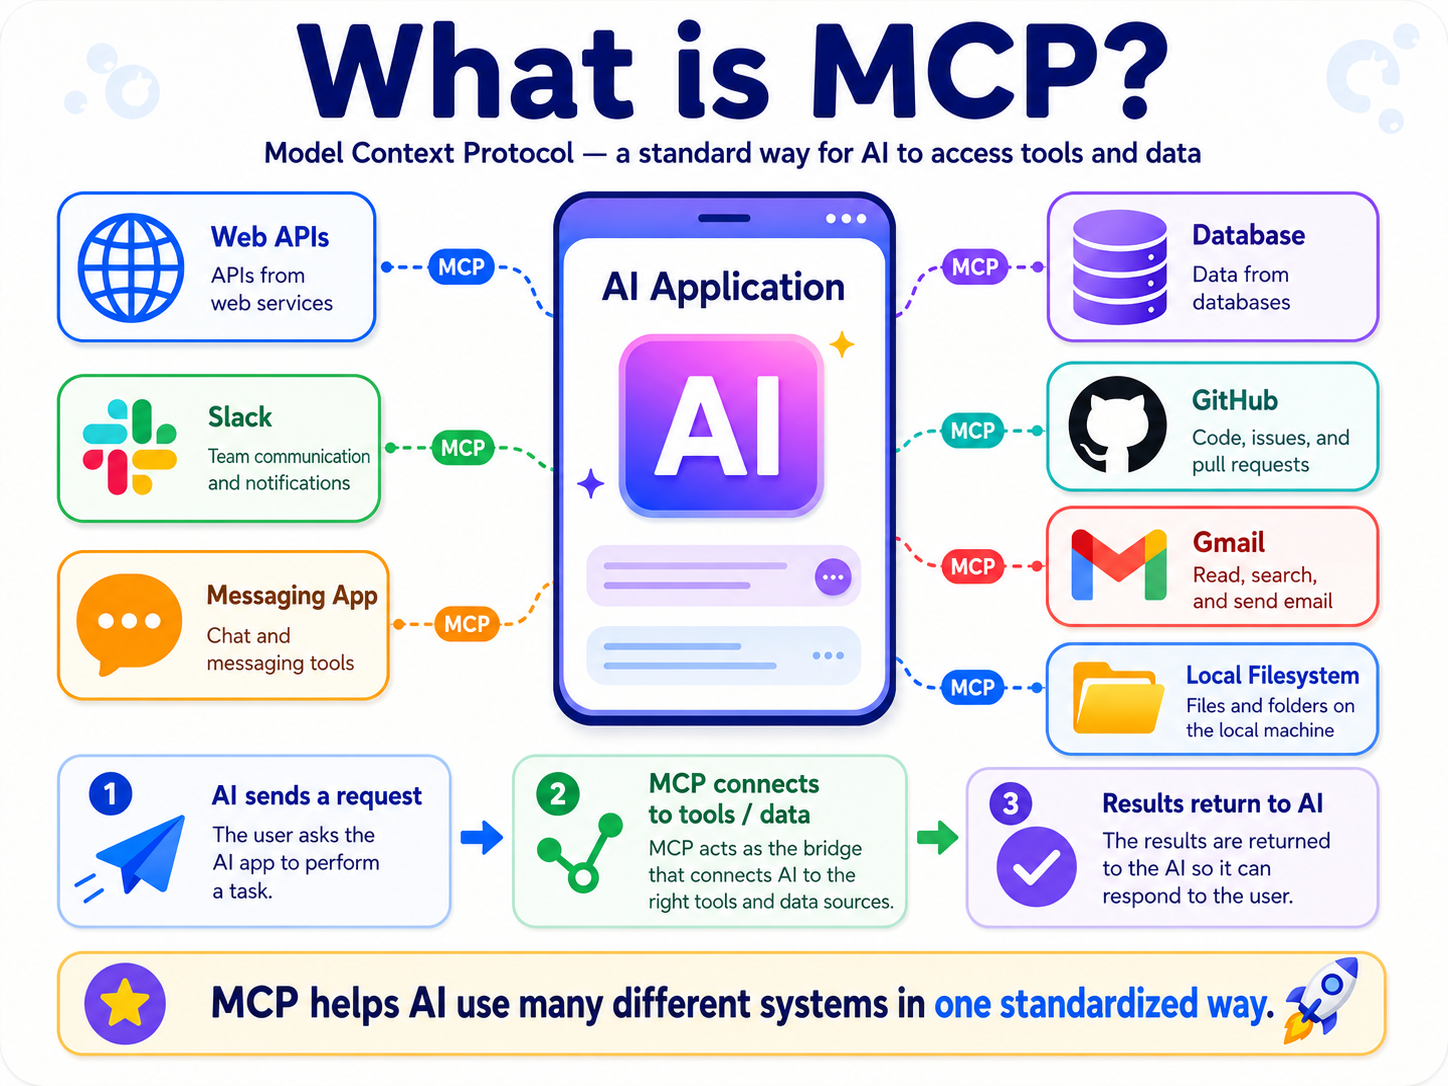
MCPがAIアプリケーションと外部システム(API、Slack、データベース、GitHub、Gmail、ファイルシステム)をどうつなぐかの全体像。
Model Context Protocol(MCP)は、この両者のあいだに共通の契約を定めます。MCPサーバーは自らの機能を入出力スキーマとともに公開し、対応するAIアプリケーションであれば同じプロトコルでそれを検出し、呼び出せます。ビジネスロジックと実際のAPI呼び出しはサーバー側に置かれます。一方、どのツールをモデルに渡すか、ユーザーにどう確認を求めるかを決めるのはホストであり、サーバーは受け取った操作について権限を確認する責任を負い続けます。MCPのドキュメントでは、この接続の標準化がUSB-Cにたとえられています。
本記事では、その考え方を実際に動くデモで確かめます。エージェントが2つのMCPツールだけを使い、ファイルの中身は一切読まずに、500個のモックファイルを拡張子と更新日で整理します。
MCPとは何か―AIモデルではなく「プロトコル」
MCPは、AIアプリケーションと、データや操作を提供するプログラムとのあいだでやり取りされるメッセージのオープンな仕様です。バージョンの合意、機能の公開、スキーマによる入力の記述、ツールの呼び出し、結果の返却という一連の流れを標準化します。逆に言えば、MCPは業務APIを置き換えるものではなく、それ自体が権限を与えるものでもなく、どのツールを呼ぶべきかを決めるものでもありません。
ファイル整理のデモでは、1回のやり取りは次のように進みます。
- ユーザーがAIアプリケーション、すなわちMCPホストにリクエストを入力します。
- ホストはFile MCPサーバー専用のMCPクライアントを作成し、接続を確立します。
- クライアントはtools/listでサーバーからツール一覧を取得します。そのうちどれをモデルへのリクエストに含めるかはホストが選びます。
- モデルがツールを選ぶと、ホストはクライアント経由でtools/callを送ります。サーバーは入力を検証し、ファイルシステムを操作して結果を返します。
- ホストはツールの結果を会話に戻し、モデルが次のステップを判断できるようにします。
この流れを追うと、アーキテクチャ上の3つの役割の境界がはっきりしてきます。ホストはユーザーが開いているアプリケーションそのもので、Claude Desktop、Claude Code、IDEなどが該当します。クライアントはホストが生成するプロトコル層のコンポーネントで、1つのクライアントが1つのサーバーと1対1の接続を保ちます。そしてサーバーは、機能を公開して実際の処理を行うプログラムです。
カスタムAPI統合ではなくMCPを使う理由
いちばん分かりやすい比較は、統合が何回必要になるかという点です。
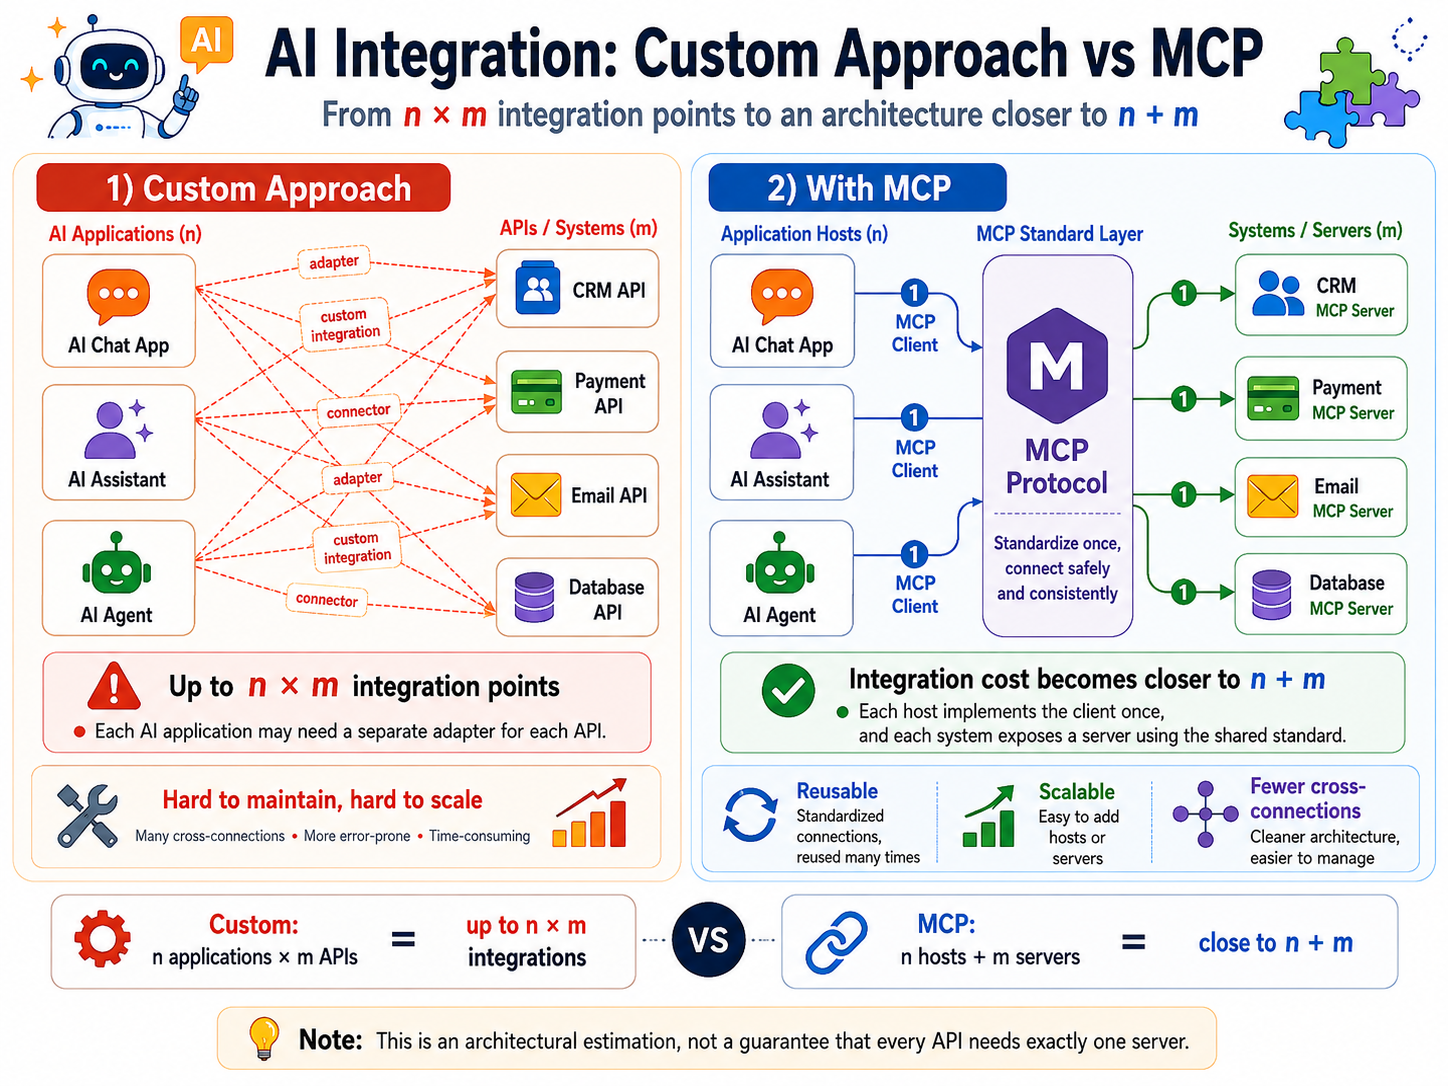
統合ポイントの比較:個別に作り込む場合は最大 n × m 個のアダプタが必要になるのに対し、MCPはコストを n + m に近づけます。
個別に作り込む方式では、AIアプリケーションごとに、APIごとのアダプタが必要になり得ます。単純なモデルで考えると、n個のアプリケーションとm個のAPIから最大 n × m 個の統合ポイントが生まれます。一方MCPであれば、各システムは共通の標準に従ったサーバーを1つ公開し、各ホストはクライアントを1度実装するだけで済みます。部品が本当に再利用できるなら、統合コストは n + m に近づきます。もっとも、これはアーキテクチャを見積もるための考え方であって、すべてのAPIにサーバーがちょうど1つで足りるというものではありません。
あわせて、次のような具体的な利点があります。
- サーバーはスキーマの定義、入力の検証、ビジネスロジックの実行を、接続してくるすべてのホストのために一度だけ実装すれば済みます。
- ホスト、あるいはモデル側のアダプタが、ツールの契約と結果をプロバイダの要求する形式に変換します。
- 1つのMCPサーバーが複数のMCPクライアントに対応できるため、API呼び出しのコードを特定のエージェントフレームワークに埋め込む必要がありません。
- クライアントは実行時にツールやリソースを検出するので、一覧全体をプロンプトにハードコードしておく必要がありません。
- モデルが目にするのは、ホストがリクエストに含めると決めたツールだけです。確認のUIや権限ポリシーは、ホスト、トランスポート、サーバーの設定に依存します。
1年間片づけていないInboxを例に
1年間だれも片づけていないフォルダを思い浮かべてください。あなたのPCにある実在のフォルダかもしれません。スクリーンショット、会議のWordファイル、PDFの請求書、売上レポート、いくつかのExcelファイルが、すべて入り混じっています。エージェントがなければ、この山を片づける方法は2つしかありません。1ファイルずつ手でドラッグ&ドロップするか、固定ルールで分類するスクリプト(拡張子がXならフォルダYへ移動)を書くかです。しかもそのスクリプトは、新しいファイル種別が増えるたびに手を入れる必要があり、特定のフォルダに固定されているため、別のフォルダで使いたければまたコードを直すことになります。
本記事のデモは、まさにその状況を再現します。スクリプトで500個のモックファイルを1つのフォルダに生成し、各ファイルの更新日を直近365日のあいだにランダムに散らして、1年間片づけていない状態をシミュレートします。
ユーザーは、整理したいパスを添えた自然言語の指示を1つ出すだけです。エージェントはまずファイル一覧を取得し、続いてmove_filesを呼び出します。サーバー自身が拡張子と更新日から移動先フォルダを決め、種類別、さらに年/月/日別にファイルを振り分けます。
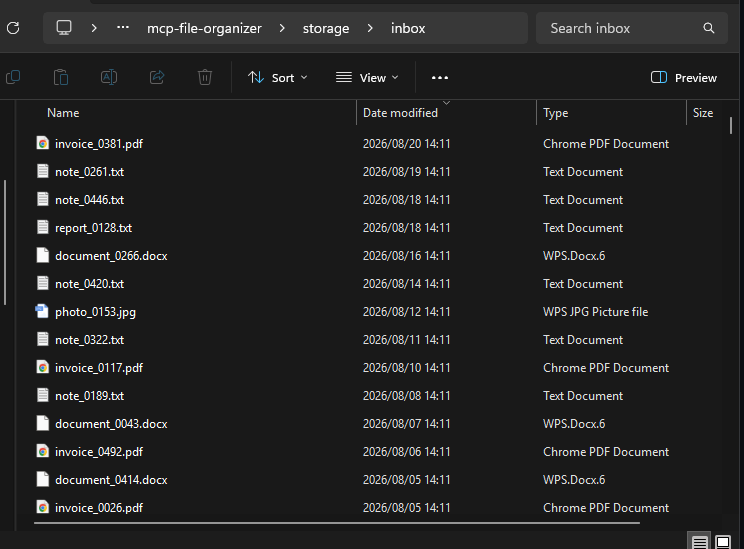
処理前のstorage/inbox:さまざまな拡張子が混在した500個のモックファイル。
アーキテクチャ
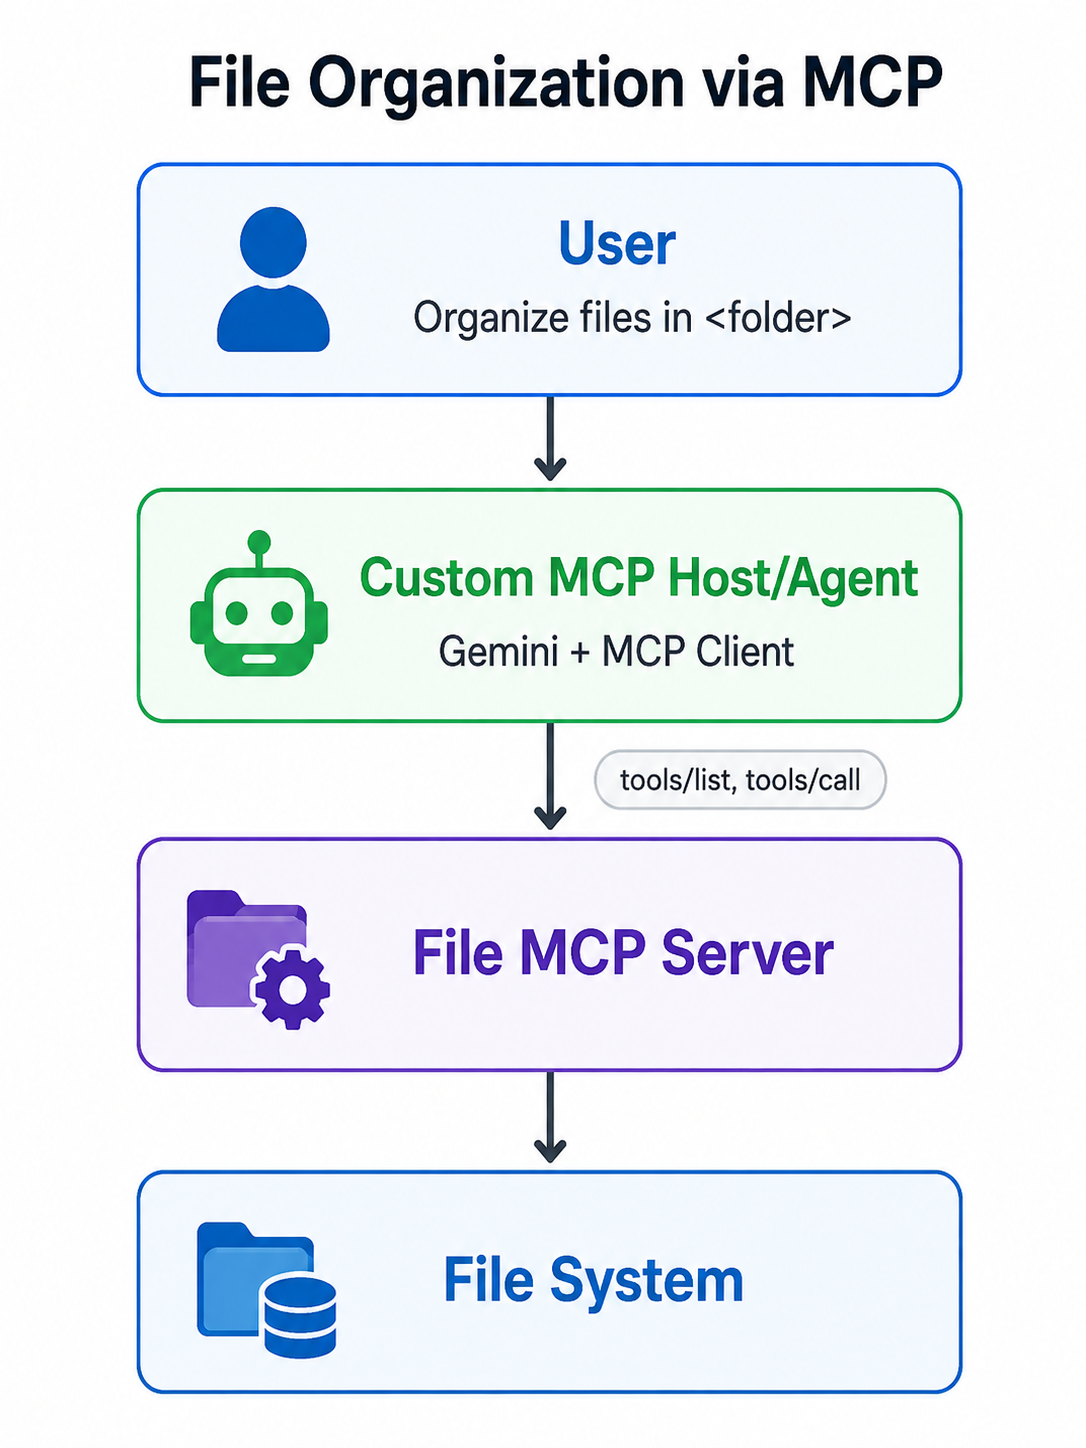
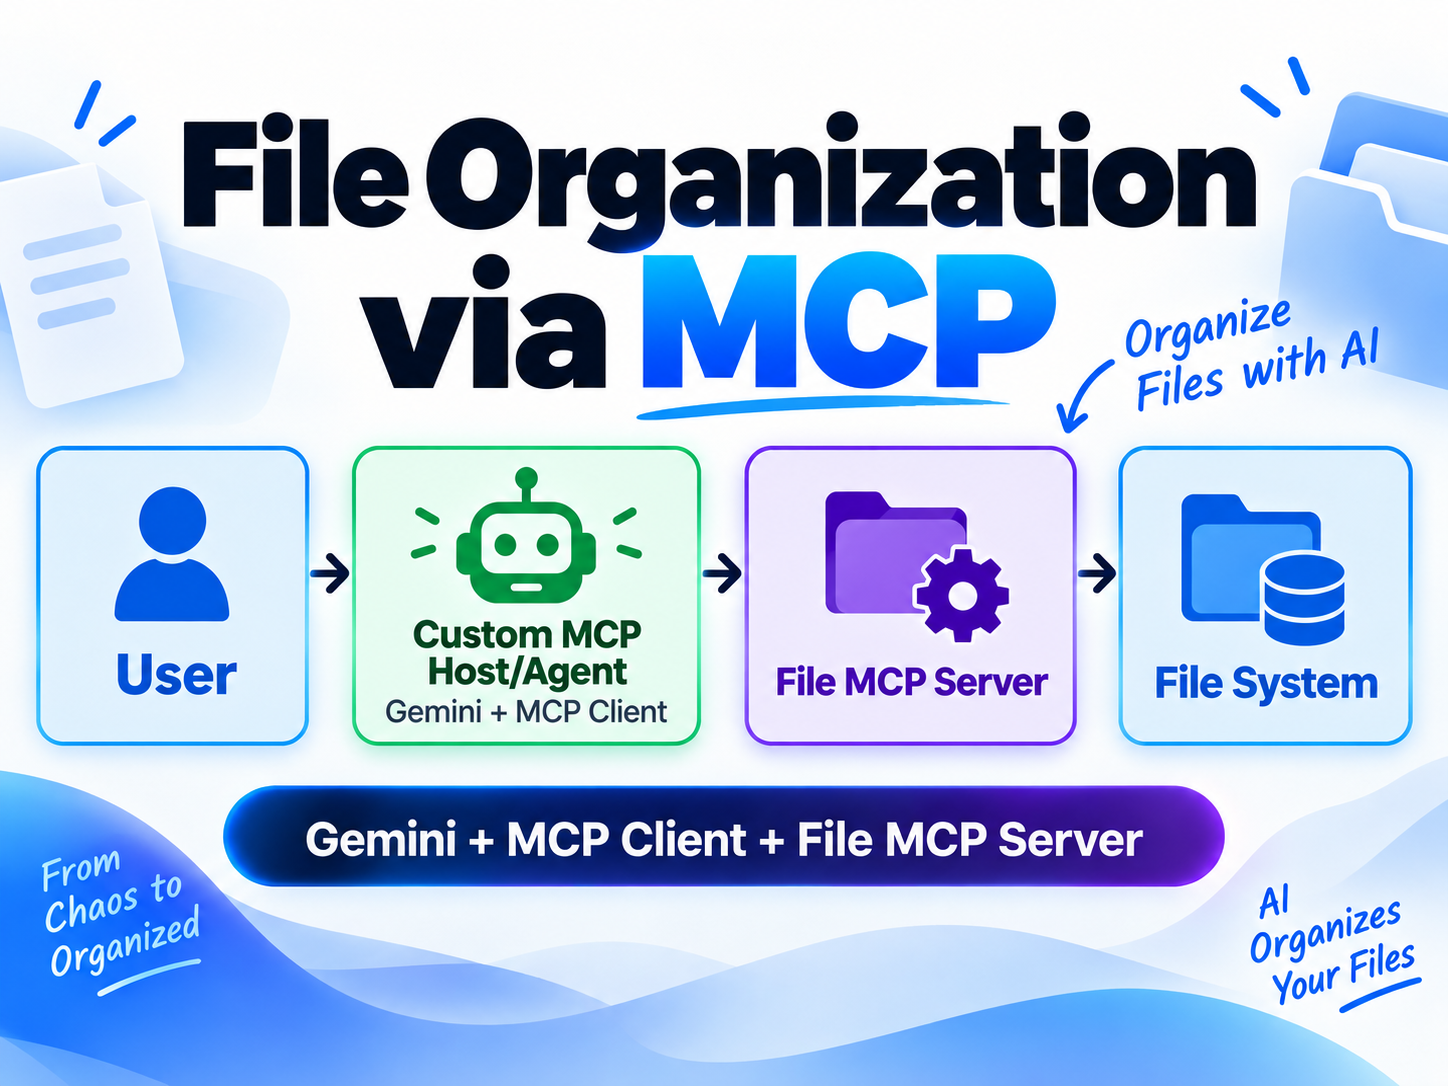
デモの呼び出しフロー:User → Custom MCP Host/Agent(Gemini + MCP Client)→ File MCP Server(list_files、move_files)→ Local File Storage。
client.ts がカスタムホスト/エージェントのアプリケーションです。その中のmcpClient変数がサーバーへのプロトコル接続を保持し、ツールと引数を選ぶのはGeminiです。File MCPサーバーがファイルの一覧取得と移動を行い、実データはファイルシステムが保持します。
サーバーにはファイルの中身を読むツールがないため、請求書、写真、ドキュメントの内容がモデルに送られることはありません。モデルに見えるのは、ファイル名、拡張子、更新日だけです。
MCPサーバーを作る―list_filesとmove_filesの2ツール、ファイルの中身は読まない
サーバーは2つのツールを登録します。最初のスニペットには list_files のスキーマ宣言とハンドラだけを載せています。パスを検証するヘルパーやメタデータを読む処理は、完全なソースにあります。
// server/server.ts

import { McpServer } from "@modelcontextprotocol/server";
import { StdioServerTransport } from "@modelcontextprotocol/server/stdio";
import { z } from "zod";
import fs from "node:fs/promises";
import path from "node:path";

const server = new McpServer({ name: "file-organizer", version: "1.0.0" });
server.registerTool("list_files", {
  description: "List direct child files and their modification dates.",
  inputSchema: z.object({ folder: z.string() }),
}, async ({ folder }) => {
  const root = resolveFolder(folder);
  const entries = await fs.readdir(root, { withFileTypes: true });
  const files = await Promise.all(entries.filter((entry) => entry.isFile()).map(async (entry) => ({
    name: entry.name,
    extension: extensionOf(entry.name),
    modified: isoDateOf((await fs.stat(path.join(root, entry.name))).mtime),
  })));
  return { content: [{ type: "text", text: JSON.stringify(files) }] };
});
move_files はバッチ単位で受け取ります。to_folder は任意で、省略するとサーバーがそのファイル自身の更新日から <extension>/<year>/<month>/<day> を導き出します。そのため、リクエストで明示しなくてもデフォルトの分類が効きます。完全なソースにある moveOneFile が検証を行い、上書きしない方式でハードリンクを作成してから元ファイルを削除します。1件が失敗しても、残りの処理は止まりません。dry_run を使えばファイルシステムに触れずにバッチ全体をプレビューでき、実際の結果には移動したファイル数を示す summary の行も付きます。
server.registerTool("move_files", {
  description: "Move files under organized/ without overwriting existing paths.",
  inputSchema: z.object({
    folder: z.string(),
    moves: z.array(z.object({ name: z.string(), to_folder: z.string().optional() })).min(1),
    dry_run: z.boolean().optional(),
  }),
}, async ({ folder, moves, dry_run }) => {
  const root = resolveFolder(folder);
  const results = [];
  for (const { name, to_folder } of moves) {
    try {
      const message = await moveOneFile(root, name, to_folder, dry_run);
      results.push({ name, to_folder, ok: true, message });
    } catch (error) {
      results.push({ name, to_folder, ok: false, error: String(error) });
    }
  }
  return { content: [{ type: "text", text: JSON.stringify({ results }) }] };
});

const transport = new StdioServerTransport();
await server.connect(transport);
そして最後の2行が、サーバーが実際に動き出す箇所です。StdioServerTransport は、サーバーが自身のプロセスのstdin/stdout経由で通信することを宣言します。つまりホストは、プロセスの起動方法さえ分かれば接続できるということです。
設計上のポイントが2つあります。1つ目は、ファイルを整理するMCPサーバーに、ユーザーのファイルの中身を読む機能は必要なく、持たせるべきでもないという点です。分類には名前、拡張子、更新日で十分です。2つ目は、folderがプロジェクト内の固定のサブフォルダ名ではなく、任意の絶対パスだという点です。そのため、マシン上のどの実フォルダでも整理できます。
folder がこのように自由であるため、サーバーは環境変数 ALLOWED_ROOTS も読み込みます。これは絶対パスのリストで、Windowsでは ;、macOS/Linuxでは : で区切り、folder はそのいずれかのroot配下になければなりません。設定しない場合、サーバーはデモのデフォルト動作としてあらゆる絶対パスを受け付けます。モックデータであれば許容できますが、実データを指すときは設定すべきです。
Geminiでカスタムホスト/エージェントを作る
client.ts は、カスタムホスト/エージェント、Gemini、MCPクライアントを同じプロセスにまとめたものです。ツールを選ぶのはGeminiで、MCPクライアントはFile MCPサーバーへのプロトコル接続だけを担当します。Gemini APIには検証時点で無料枠があり、クォータはモデルとアカウントによって異なります。
Google AI Studio でAPIキーを作成し、.env の GEMINI_API_KEY に保存します。MODEL は任意で、コードのデフォルトは gemini-2.5-flash です。
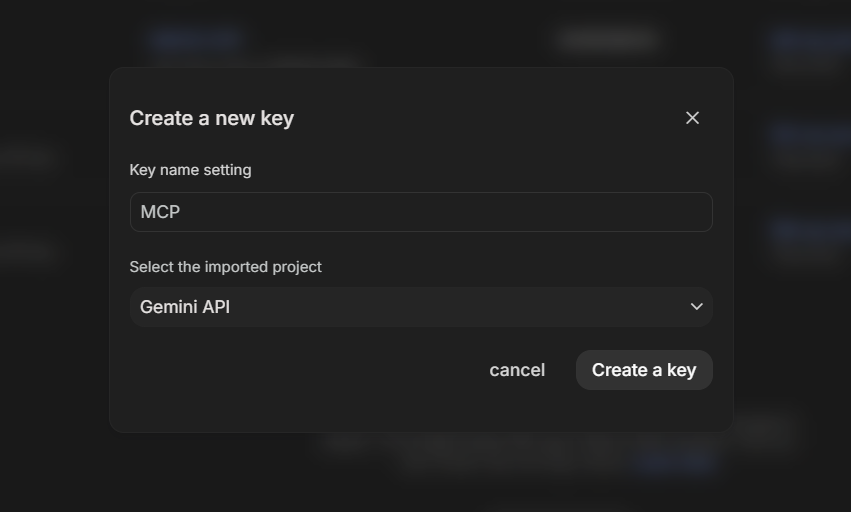
Google AI StudioでのGemini APIキーの作成:キーに名前を付け、Gemini APIのプロジェクトを選択する。
続いて、カスタムホスト/エージェントがMCPクライアントを生成し、stdio経由でサーバーに接続します。パスの算出とツール呼び出し回数の上限は、完全なソースにあります。
// client/client.ts

import { Client } from "@modelcontextprotocol/client";
import { StdioClientTransport } from "@modelcontextprotocol/client/stdio";

const transport = new StdioClientTransport({
  command: process.execPath,
  args: ["--import", "tsx", serverPath],
  env: { ALLOWED_ROOTS: process.env.ALLOWED_ROOTS ?? "" },
});
const mcpClient = new Client({ name: "file-organizer-agent", version: "1.0.0" });
await mcpClient.connect(transport);
検証環境(2026-08-27時点):Windows 11、Node.js 24.15.0、@modelcontextprotocol/client 2.0.0、@modelcontextprotocol/server 2.0.0、@google/genai 2.17.0、Zod 4.4.3、tsx 4.23.12、TypeScript 7.0.2。MCP TypeScript SDK v2ではクライアントとサーバーが2つのパッケージに分かれました。v1では@modelcontextprotocol/sdkという統合パッケージを使います。
mcpToTool は、検出したMCPツールをGeminiが使うインターフェースへ変換します。これは @google/genai 独自の統合で、バージョン2.17.0の時点ではまだexperimentalです。別のプロバイダのSDKでは、異なるアダプタやツール呼び出しループが必要になる場合があります。
import { GoogleGenAI, mcpToTool } from "@google/genai";

const ai = new GoogleGenAI({ apiKey: process.env.GEMINI_API_KEY });
try {
  const response = await ai.models.generateContent({
    model: MODEL,
    contents: USER_REQUEST,
    config: {
      tools: [mcpToTool(mcpClient)],
      automaticFunctionCalling: { maximumRemoteCalls: MAX_TOOL_CALLS },
    },
  });
  console.log(response.text);
} finally {
  await mcpClient.close();
}
なお、Claude DesktopとClaude Codeも、このサーバーを登録できるMCPホストです。ほかのプラットフォームがMCPに対応している場合もあります。モデルプロバイダを変えても、File MCPサーバーとツールの契約はそのままで構いませんが、ホスト/エージェント側は通常、SDK、APIキー、アダプタ、場合によってはツール呼び出しループまで変更が必要になります。
実際のフォルダを整理するには、次を実行します。
npm run agent -- "absolute_path"
デモを動かす―500ファイルでの実際の結果
実行は2回のツール呼び出しで完了しました。list_files が1回、move_files が1回です。結果は storage/inbox/organized/<extension>/<year>/<month>/<day>/ 配下に出力されます。以下の画像は、その実行のトランスクリプトとディレクトリ構成です。
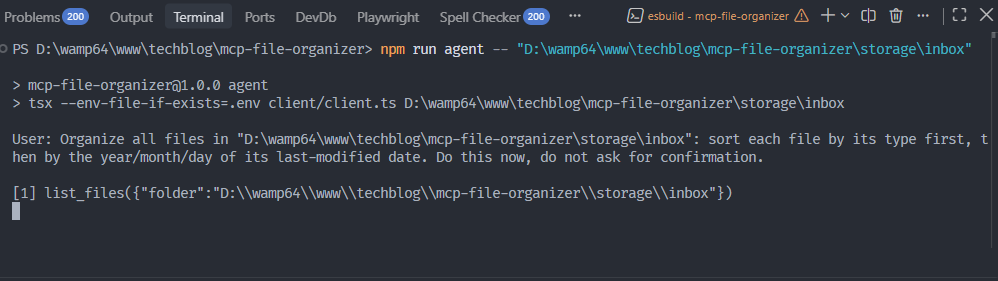
実行開始時のターミナル:npm run agentコマンドと、最初のlist_files呼び出し。
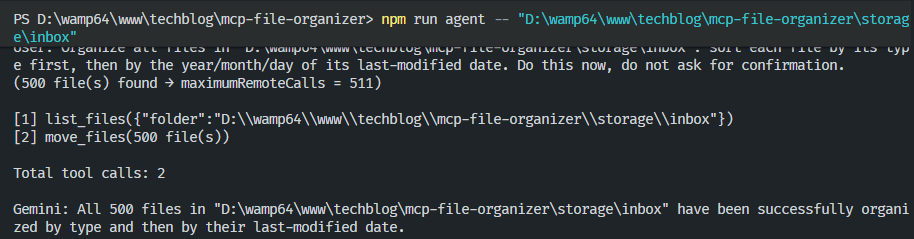
実行終了時のターミナル:最後のmove_files呼び出し、合計2回のツール呼び出し、そしてGeminiからの完了メッセージ。
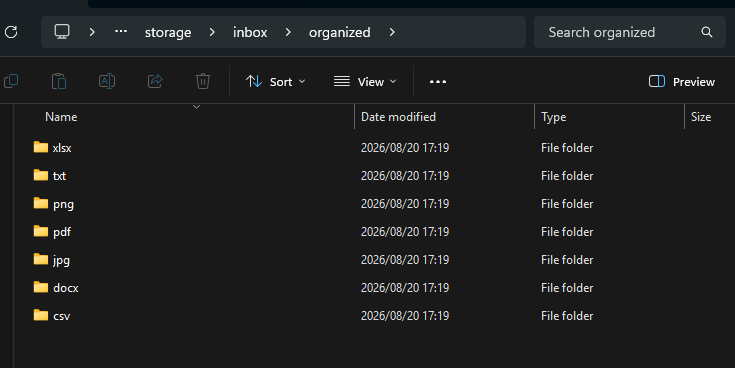
実行後のorganizedフォルダ:xlsx、txt、png、pdf、jpg、docx、csvの7つの拡張子に分かれている。
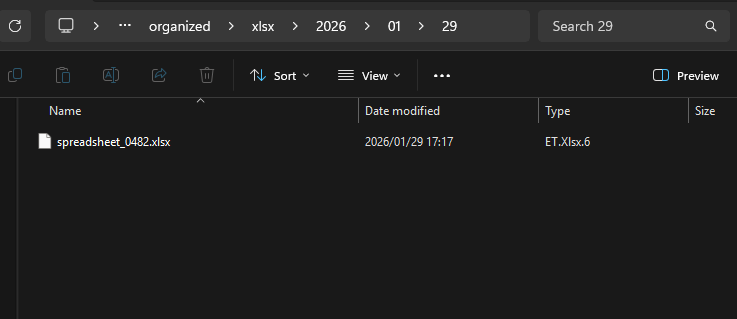
個別のサブフォルダの例:organized/xlsx/2026/01/29には、その更新日に一致するファイルがちょうど1つ入っている。
ずいぶんすっきりしたと思いませんか。探すときは、拡張子と更新日さえ覚えていれば十分です。
このサーバーをClaude DesktopまたはClaude Codeに登録する
ここまでの client.ts は、デモ用に自作したホストでした。もう1つの使い方として、ビルド済みのサーバーファイルをClaude DesktopやClaude Codeに登録する方法があります。この場合、接続、tools/list、ツール呼び出しループはホスト側が管理します。
Claude Desktopでは、Settings → Developer → Edit Configを開き、claude_desktop_config.jsonを編集します。Windowsの通常のインストールでは %APPDATA%\Claude\claude_desktop_config.json を使います。Microsoft Store版では、次のMSIXパスを使う場合があります。%LOCALAPPDATA%\Packages\<PackageFamilyName>\LocalCache\Roaming\Claude\claude_desktop_config.json。
このファイルに書くパスは、絶対パスでなければなりません。ファイルがまだない場合は、新しく作成してください。
{
  "mcpServers": {
    "file-organizer": {
      "command": "node",
      "args": ["absolute_path/dist/server/server.js"],
      "env": { "ALLOWED_ROOTS": "C:\\Users\\you\\Downloads" }
    }
  }
}
ALLOWED_ROOTS には、整理対象のフォルダを正確に含める必要があります。上の例ではDownloadsしか許可していないため、デモのモックデータで試す場合は storage\inbox の絶対パスに変更してください。
Claude Codeでは、プロジェクトスコープとしてプロジェクトルートの .mcp.json を使います。.mcp.json 内の相対パスは、ファイルの位置ではなくClaude Codeプロセスのワーキングディレクトリを基準に解決されます。そのため絶対パスを書くか、Claude Codeがサーバーのサブプロセス向けに設定する ${CLAUDE_PROJECT_DIR:-.}/dist/server/server.js という変数を使ってください。
Claude Desktopでの結果
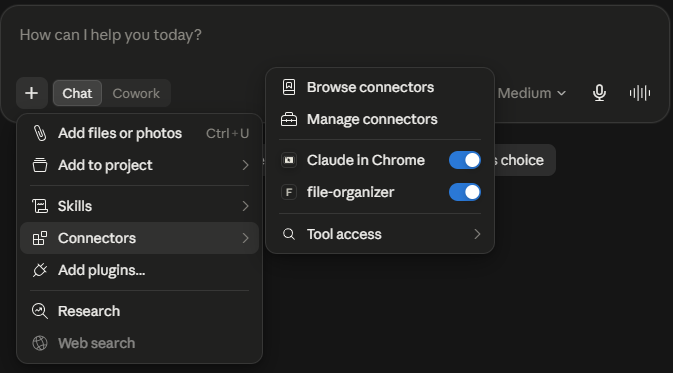
Claude Desktop:Connectorsでfile-organizerコネクタを有効にする。
Claude Codeでの結果
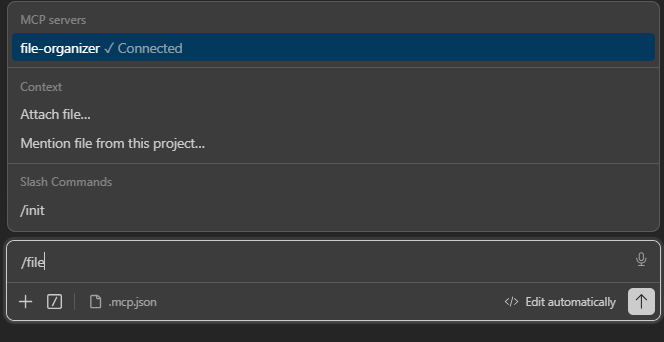
Claude Code:.mcp.json経由でfile-organizer MCPサーバーがConnected状態になっている。
実際のDownloadsフォルダで再現してみます。
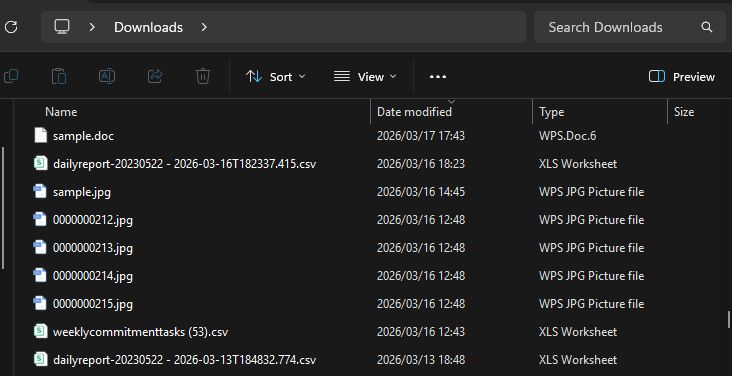
マシン上の実際のDownloadsフォルダ。モックデータ以外でデモを試すために使用。
Claudeは必要なツールをMCPサーバーから自分で見つけます。
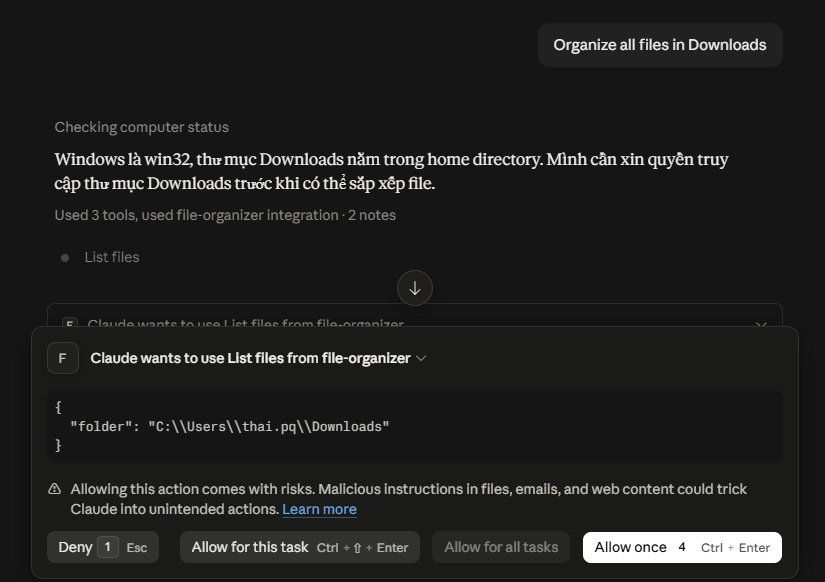
Claudeはfile-organizerのList filesツールを自ら選んで呼び出し、Downloadsフォルダを読む前に権限を求めている。
MCPが実際に標準化しているもの
このデモから、標準化されているのは次の3つだと分かります。
- Discovery(検出):クライアントは実行時にtools/listでツールとスキーマを取得します。
- Invocation(呼び出し):クライアントはすべてのツールをtools/call経由で呼び出し、MCPの構造で結果を受け取ります。
- 実装の境界:エージェントが依存するのは
list_filesとmove_filesであり、fs.readdirやfs.renameに直接依存するわけではありません。
アーキテクチャの観点で言えば、list_files と move_files の背後にあるバックエンドは、ローカルのファイルシステムからGoogle Drive、OneDrive、S3へ差し替えられます。それでも、エージェントがツールを理解し呼び出す方法は変わりません。
                MCP Server
                    │
        ┌───────────┼───────────┐
        ▼           ▼           ▼
   Google Drive   OneDrive      S3
MCPは、エージェントがツールの契約を理解する部分と、サーバーがツールを実装する部分とを切り離す。
MCPが統合コストに見合うのはどんなときか
MCPが向いているのは、ある機能を複数のホスト、モデル、開発チームで再利用したい場合、ツール一覧を実行時に検出する必要がある場合、あるいは権限とビジネスロジックの境界をエージェントから独立させてサーバー側に保ちたい場合です。たとえば、ERPからの在庫照会、配送ステータスの取得、社内レポートの検索、チケットの作成などが挙げられます。
逆に、アプリケーションが1つ、呼び出すAPIも単純なものが1つだけなら、直接アダプタを書いたほうがコード量は少なくて済むのが普通です。また「拡張子でファイルを振り分ける」のように問題が完全に決まりきっている場合は、エージェントを立てて自分で判断させるより、素直なスクリプトのほうが安上がりで予測もしやすいままです。そのエージェントがmove_filesのようなバッチ処理ツールをすでに使っていたとしても、この点は変わりません。
このデモを自分で動かす手順
デモをいちばん手早く体験する方法は、既存のMCPホスト(Claude DesktopまたはClaude Code)にサーバーを登録し、チャット欄に自然言語でリクエストを打ち込むことです。これは実務でのMCPの使われ方そのものでもあります。以下の手順は、Node.js LTSを入れたWindowsを前提としています。
- リポジトリをcloneし、cloneしたフォルダでPowerShellを開きます:
git clone https://github.com/bwv-labs/mcp-file-organizer.git、続いてcd mcp-file-organizer。 npm ciを実行し、lockfileどおりのバージョンをインストールします。npm run testを実行し、続いてnpm run generate-mockでstorage/inboxに500個のファイルを作成します。npm run buildを実行してdist/server/server.jsを生成します。- ビルド済みのJavaScriptファイルを前述の手順で登録し、
ALLOWED_ROOTSに整理対象のフォルダ(ここではリポジトリのstorage\inboxの絶対パス)を正確に設定します。 - ホストを再起動するか新しいセッションを開き、そのモックフォルダを整理するよう依頼します。
プロンプトの例:
D:\path\to\mcp-file-organizer\storage\inbox にあるファイルをすべて整理してください
ツールにファイルの書き込みを許可する前に、ホスト側で適用されている権限を確認してください。実行後は、storage/inbox/organized配下で結果を確認できます。
おわりに
MCPは、冒頭で述べた問題を解決します。アプリケーションとAPIの組み合わせごとに専用のアダプタを用意するのではなく、1つのMCPサーバーが互換性のある複数のホストに対応できるため、部品が本当に再利用されるなら、統合コストはおおよそ n × m から n + m に近づきます。とはいえ、分類ルールが安定しているなら、固定のスクリプトのほうが依然としてシンプルです。このデモの価値は、同じMCPサーバーのファイルが、Geminiを使うカスタムホスト/エージェントとClaude Desktopの両方で、list_filesとmove_filesの契約を変えないまま動いたことにあります。