AI を活用したテスト自動化 ― 手動テストから自動テストへ
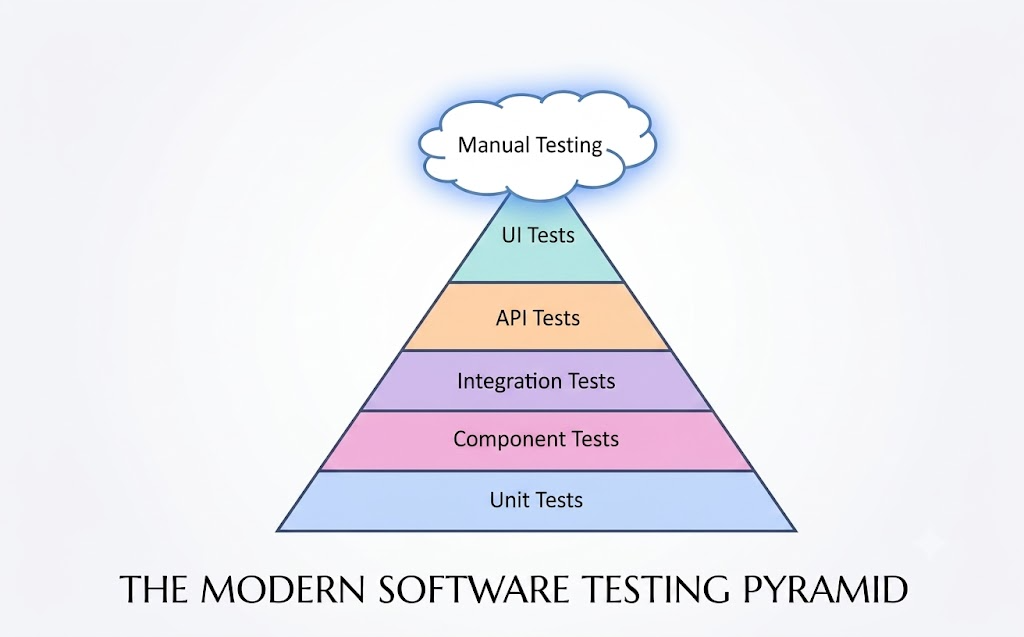
図1:現代のテストピラミッド
画像出典:James Willett 氏の記事「The Evolution of the Testing Pyramid」
手動テストから自動テストへの道のりを歩み始めるとき、最大の壁はプログラミングの文法を覚えることではなく、テストに対する考え方を切り替えることにあります。堅実な自動化戦略を組み立てるには、まずテストピラミッドの各層がどこに位置し、どんな役割を担うのかを押さえることが第一歩になります。
テストピラミッドは、テストのレベルを土台から頂点まで視覚的に分けたモデルです。
- Unit Tests(UT): 最も広い最下層に位置し、ソースコード内の個々の関数や最小単位のロジックが正しいかを確認します。実行が最も速く、バグを見つけたときのコストが最も小さい層です。
- Component Tests(CT): ラベル、色、プレースホルダーといった UI の一部品や、機能単位のモジュールを、結合前の独立した環境で検証します。
- Integration Tests(IT): モジュールどうしを組み合わせたときの相互作用と、データの受け渡しの流れを確認します。
- API Tests: サーバー側とアプリケーションのあいだでデータをやり取りする窓口と、その処理ロジックを確認します。
- UI Tests(E2E Test): ピラミッドの頂点近くに位置し、画面上でユーザーが実際に行う一連の操作を丸ごと再現する役割を担います。
- Manual Testing: 最上部を覆う雲の層。探索的テスト、実際の使い心地の評価、そして自動化された手順ではまだ完全に置き換えられない柔軟な対応を担当します。
この全体像をつかんでおくと、Communicator(以下、COM) チームは自動化をどこに適用すれば最も価値が出るのかを正確に判断できます。今日の AI はそのための強力なてこであり、テストシナリオを書く時間を短縮し、テスト工程を標準化して、自動テストへのスムーズな移行を後押ししてくれます。
※注: 本記事は自動テストを対象としますが、API Tests は除きます。API Tests は大規模なマイクロサービス案件に向いた手法であり、手動から自動へ工程を切り替えたい本記事の対象とは異なるためです。
AI を用いたテスト工程の構成
チャット画面で自由記述のプロンプトをそのまま打つやり方では、生成結果が散らばり、安定しません。AI がロジックを推測で埋めてしまったり、重要なエッジケースを落としてしまったりしがちです。
自動テストを実務で回すには、プロジェクトを明確な工程として組み立てる必要があります。この工程は、共通の基準を形づくる固定のルール層と、システムの層ごとにはっきり分離された2本の独立したテストパイプラインから成ります。
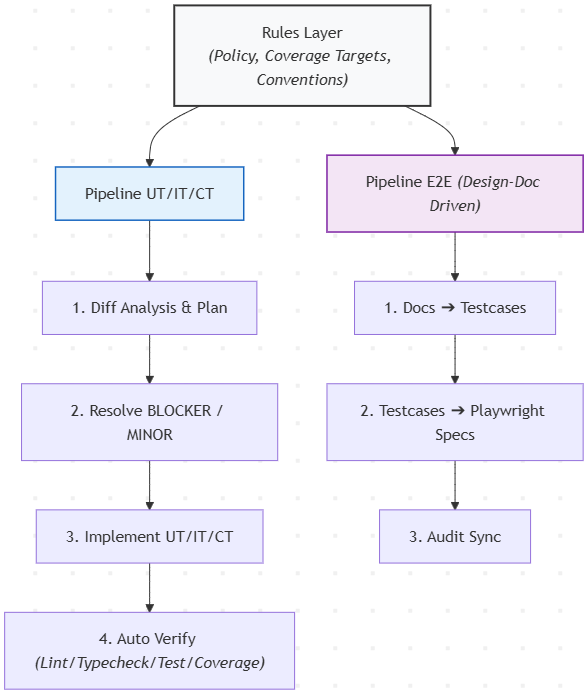
図2:テスト工程
1. プロジェクトルールの設定
AI にテストシナリオやテストコードを書かせる前に、プロジェクトとして統制ルール一式を定めておく必要があります。これは、すべてのAI エージェントと開発者が従う技術ポリシーにあたるものです。
- テスト戦略: 各テスト層の役割をはっきり定めます。UT と CT はソースコードレベルの技術的な盾として、処理関数と個々の UI 部品を漏れなく網羅する役割を担います。一方 IT と E2E Test は、従来の手動テストチェックリストの条件を、そのまま自動テストへ置き換えることに集中します。この層では、開発者と COM のあいだで行うテストシナリオのレビュー手順、そしてテストコードを書くときの技術基準も細かく定めます。
- カバレッジ目標: 従来の手動テストチェックリストを、ディレクトリやモジュールごとのカバレッジ目標マトリクスへ変換します。決済処理や数値計算といった業務の中核モジュールは100%、共通ディレクトリは最低80%といった具合です。どの条件を自動化し、どの条件を手動テストとして残すのかを明確に分類したマトリクスのファイルを、プロジェクトとして維持します。
- テストコードのコーディング規約: 画面要素の識別子の付け方、ディレクトリ構成、テスト名の命名規則、そしてプロジェクトで用いるモックデータの扱い方を、統一して定めます。
2. UT・IT パイプライン
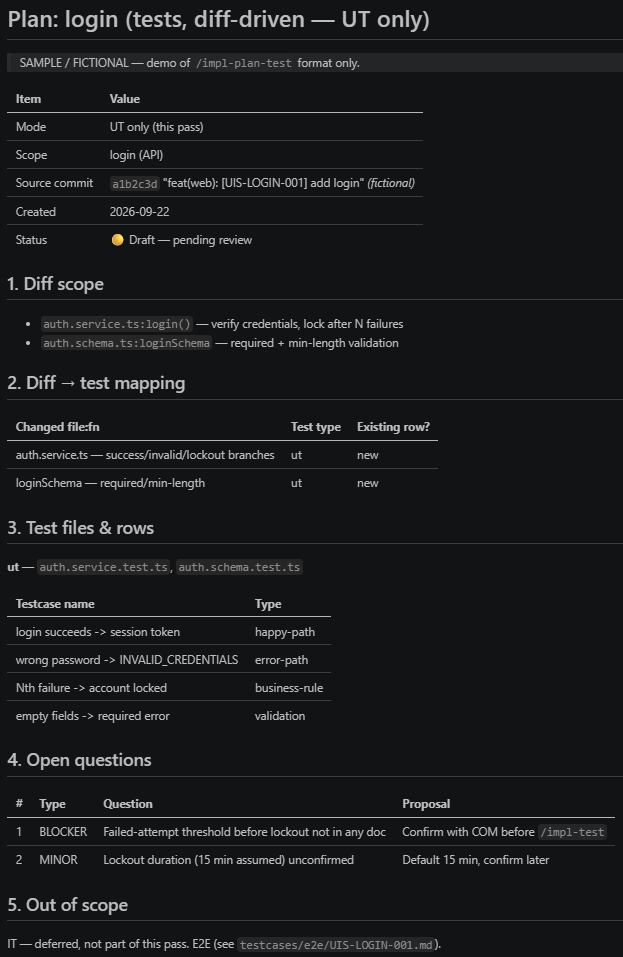
図3:Unit Test のプラン
このパイプラインは、開発者向けの Unit Test、Integration Test、Component Test の作成を担います。処理の流れは、プロジェクト全体を走査するのではなく、実際のコード変更を起点に動きます。あわせて Component Test を下層に置き、ボタン・入力欄・データテーブルといった個々の UI コンポーネントを検証することで、上層の E2E テストの負荷を下げます。
- Git diff で対象範囲を絞る: AI は Git の commit diff を解析し、変更された関数、ロジックの分岐、UI 部品を正確に特定します。その変更点を対応する API 仕様やコンポーネント設計と突き合わせ、書くべきシナリオ(UT・IT・Component Test のどれか)を割り振り、プランのファイルとして出力します。
- BLOCKER と MINOR による課題の切り分け: プラン作成の途中で、業務ドキュメント・モック・実装コードなどのあいだに食い違いが見つかった場合、AI は勝手にロジックを推測しません。代わりに、未解決の疑問点にラベルを付けてプランのファイルへ書き残します。
- BLOCKER: ロジックの重大な矛盾や、仕様情報の欠落に使います。この場合は工程をいったん止め、先にすべてを明確にします。
- MINOR: 書式やパラメータといった細かい点に使います。AI は既定案を提示しますが、警告ラベルは残したままにします。
テストコードを書く工程へ進めるのは、プラン内の BLOCKER ラベルがすべて開発者によって解消されたあとだけです。 - テストコード作成時の権限の切り分け: エージェントは承認済みのプランのファイルを受け取り、テストコードを書きます。このエージェントには権限の制限がかかっており、アプリケーションのソースコードには一切手を出せません。テストが失敗した場合、エージェントは失敗したテストをそのまま残してバグとして報告します。テストを通すために AI が製品コードを勝手に直してしまう事態を防ぐためです。
- 自動チェックのループ: AI が作成したテストファイルは、linter、型チェック、テストの実行、カバレッジ閾値の突き合わせという一連のチェックを必ず通過しなければなりません。
3. E2E パイプライン
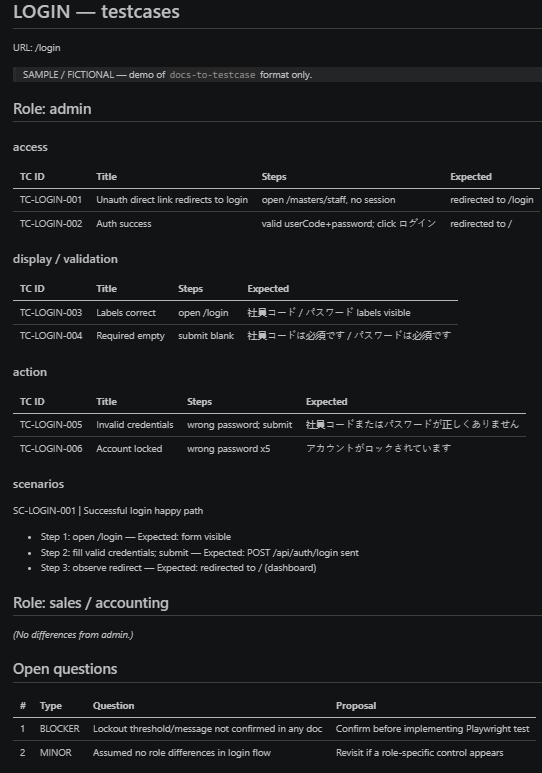
図4:E2E テストのプラン
UT・IT・Component Test とは異なり、E2E パイプラインは画面設計書をもとに動きます。現在のアプリケーションのコードから独立した、客観的な視点を保つためです。下層の Component Test が個々のウィジェットの表示状態を細かく確認しているので、E2E のシナリオはシステム全体を貫くユーザーの業務フローの確認に専念できます。
- ドキュメントからテストシナリオへの変換: AI は外部の画面設計書だけを読み、Markdown 形式のテストシナリオファイルへ変換します。単独のケースも、複数ステップにまたがるケースも、標準化された枠組みに沿って書き出されます。
- シナリオから E2E コードへの変換: AI はテストシナリオを、完成した Playwright の spec ファイルへ変換します。Page Object Model を適用し、設計書どおりの期待文言をアサートします。実際のアプリの挙動がシナリオと違った場合は、シナリオをアプリに合わせて直すのではなく、テストを失敗させてバグとして記録します。
- Testcase Sync Audit: 読み取り専用で動く監査ツールを定期的に走らせ、プラン上のシナリオ一覧とコード内の実際のテストを突き合わせます。不足しているシナリオ、余分なシナリオ、未完成のシナリオをその場で洗い出せます。
自動テストレポートの設計
手動テストから自動化へ移るとき、開発者と COM・プロジェクト管理者のあいだに生まれる最大の壁は、業務的な文脈が途切れてしまうことです。
従来の手動テストのチェックリストでは、データが Screen 名、Function のグループ、ユーザー権限、操作手順の詳細といった形ではっきり分かれています。ところが自動テストのレポートは、既定のままだと、ソースファイルの一覧や処理関数の名前が、成功・失敗の状態とともに羅列されるだけです。これでは COM にとって確認が非常に難しく、シナリオの抜け漏れがあるかどうかも分かりません。
この課題を解決するには、自動テストレポートの画面を、情報を一元化したダッシュボードとして設計し、全体像と詳細の両方を1か所に集める必要があります。ソースコードを開かなくても、システムの品質状態をすぐにつかめるようにするためです。
1. レポートに欠かせない情報要素
自動テストのレポートには、システム全体の概観から個々の業務シナリオの詳細まで、複数の視点が必要です。欠かせない情報は、次の3つのブロックに分かれます。
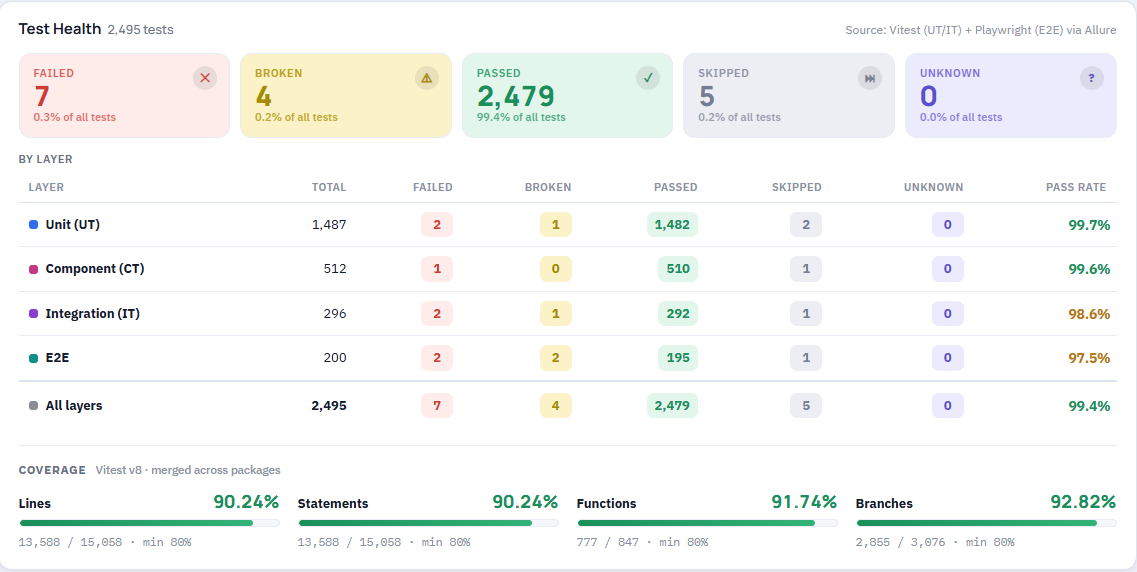
図5:テストレポート内の Test Health の表示
- テストの健全性指標(Test Health)と Test Coverage:
- システム内のテスト総数をまとめた表。Passed、 Failed、 Skipped、 Broken、 Unknown の5状態で視覚的に分類します。
- UT・CT・IT・E2E の各テスト層について、テスト件数と Pass Rate を分けて集計したマトリクス。
- 計測ツールから自動集計される Test Coverage。Lines、Statements、Functions、Branches の4指標でコードの網羅率を正確に表示し、安全ラインの下限(最低80%)も併記します。
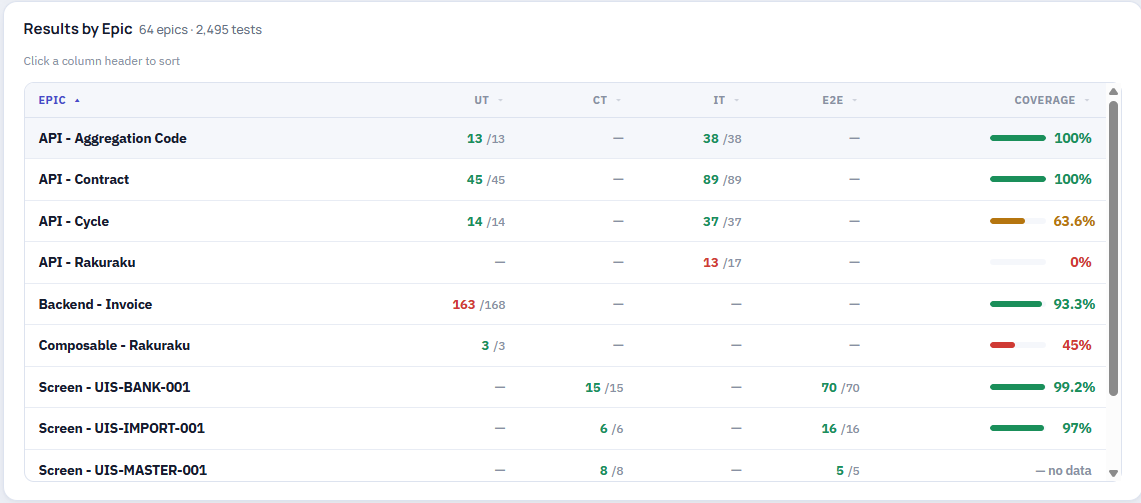
図6:Epic 単位の総合結果の表示
- Screen と Function でまとめた結果一覧(Results by Epic):
- Epic として分類された Screen、バックエンドの API、その他のコンポーネントを、すべて一覧で並べた表。
- 各 Screen や API に対応する UT・CT・IT・E2E それぞれの Pass/Total 件数を列で示し、項目ごとの Test Coverage も併せて表示します。
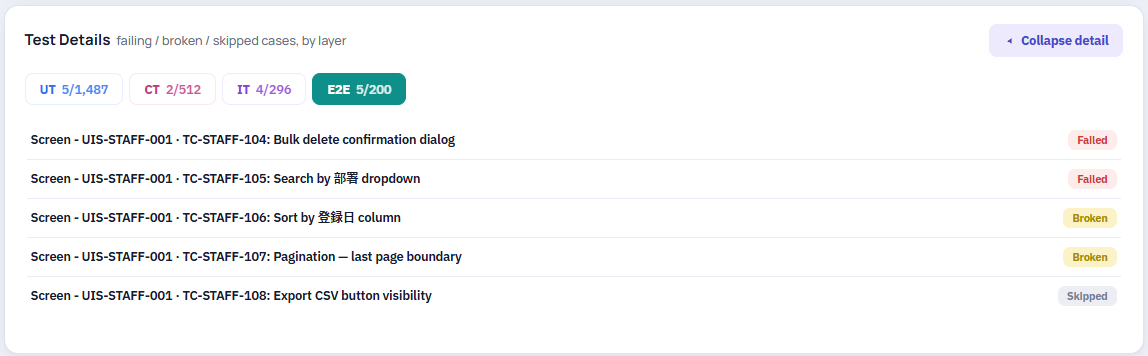
図7:失敗したテストケースの詳細
- status が passed 以外のテストケースの詳細(Test Details):
- 失敗(Failed/Broken)、スキップ(Skipped)、未分類(Unknown)のテストケースを一覧で表示する展開エリア。
- UT・CT・IT・E2E のテスト層ごとに絞り込めるフィルターを備え、読み手がすぐに問題箇所を特定できるようにします。
2. Test Case ID とテストケース名の標準化
テスト名がプログラマ目線で付けられていることが、自動レポートを COM にとって分かりにくくしている主な原因です。読み手がテスト内容を100%理解できるようにするには、コード内のテストケース名を、元の業務チェックリストに紐づく命名規則に従わせる必要があります。
テスト名には、元の Screen コード、テストシナリオのコード、そして業務の言葉による振る舞いの説明を必ず含めます。例:
- ログインのシナリオ:Screen - UIS-LOGIN-001・ TC-LOGIN-001: Enter username, password & click login button return dashboard page successful.
レポートを出力したとき、COM は Screen コード UIS-LOGIN-001 とテストケースコード TC-LOGIN-001 を見るだけで、元のファイルとすぐに突き合わせられます。
3. テスト層ごとのシナリオの切り分け
元のシナリオチェックリストをもとに、どの層にシナリオを割り当てるかは、ソフトウェアの品質と実行速度のバランスを決める要になります。
- UT・CT 層:
- Unit Test(UT): 入力データのバリデーションルール(schema、format、桁数、必須項目)、アルゴリズム、業務上の計算ロジックを担当します。
- Component Test(CT): 個々のコンポーネント、ボタン、入力欄について、表示状態と発火するイベントを独立した環境で確認します。
- この2層のテストはミリ秒単位で動くため、開発者がコードを直した直後にすぐ結果が返ってきます。
- IT 層: バックエンドの複雑な業務ロジック、ユーザー権限の処理、データベースが絡む計算ルール、API 通信のエラーケースの確認に集中します。
- E2E 層: 個々の入力欄のバリデーションや表示の確認は繰り返しません。E2E は、複数の Screen を連続してまたぐユーザーの主要な導線だけに集中します(例:契約の新規作成 → 請求書の発行 → メール送信)。
こうして切り分けておくと、テストが重複せず、レポートの実行時間を最短に保ちながら、要件を漏れなく網羅できます。
4. 抜け漏れたシナリオの素早い洗い出し
このダッシュボード型のレポート画面には、COM とプロジェクト管理者が抜け漏れをその場で見つけられる、3段階の確認の仕掛けがあります。
- Screen 一覧から確認する: Results by Epic の表で、ある Screen がすべてのテスト層でハイフン(—)になっていたり No data と表示されていたりすれば、その機能には自動テストのコードがまだ1本もない、とすぐに分かります。
- Test Coverage からの警告: ある Screen や API の Test Coverage が低い値(たとえば63.6%)を示していれば、まだ通っていない Branches や Functions が多く残っているということです。これは、エッジケースや異常系のバリデーションルールがテストスイートでカバーされていないサインです。
- 詳細一覧での即時の切り分け: Test Details のエリアでは、Pass したテストを畳んで、Failed/Broken のテストだけを UT・CT・IT・E2E の層ごとに見られます。問題箇所を素早く、正確に絞り込めます。
このように情報を1か所へ集めておくと、業務チェックリストと自動テストのコードの突き合わせが非常に速くなり、管理コストを増やさないまま品質の見通しを保てます。
自動テストでよく起きる問題
1. フレーキーテストへの対策
テストが通ったり落ちたりする(flaky)現象は、UI の非同期性と、複数の E2E シナリオを並列実行したときに DB サーバー側で起きるリソースの競合に起因することが多いです。
- 固定の待機関数の禁止と、条件付き待機の徹底: sleep や delay といった固定待機は完全に禁止します。テストコードでは Explicit Wait や Web-first Assertions を使い、API の応答と DOM の状態を自動で待つようにします。実行速度の最適化にもつながります。
- DB インフラの最適化と並列数の制限(Concurrency Throttling): E2E 実行時に DB サーバーが過負荷になってランダムなタイムアウトを起こすのを避けるため、インフラの能力に見合ったワーカーの並列数を設定します。あわせてコネクションプールを最適化し、データ準備は UI 上の余計な操作をバイパスして API で行います(トレードオフがあるため、採用は慎重に判断します)。
- E2E シナリオ単位の自動リトライ設定: インフラの揺らぎや一時的なネットワーク遅延で E2E テストが落ちる場合に備え、結果を返して最終レポートを出す前に自動リトライを走らせます。
2. テストデータの分離
後から走ったテストが理由もなく落ちる原因として多いのが、先に走ったテストが共有データベース上のサンプルデータを書き換えたり消したりしていた、というものです。
- 独立したデータを自前で用意する: どのテストも、操作を始める前に、必要なデータセットを API 経由で自分で準備しなければなりません。
- 自動クリーンアップ(Cleanup/Teardown): テストが終わった時点で、作成した不要データを削除するか、元の状態へ戻す処理を必ず走らせます。
- 並列実行するシナリオ間でのデータ共有の禁止: 並列実行時にサンプルデータを共用することは絶対に避けます。スレッド間でのデータ競合を防ぐためです。
3. 実行時間の最適化とテストスイートの正確性
テストスイートが数千シナリオまで膨らむと、実行時間が延びて CI/CD の流れが詰まります。同時に、目視ではテストケースを見落としやすくなり、孤立したテストが残ったり、新しいテストケースが抜けたりします。
- 実行時間の最適化(Parallel Execution & Targeted Run): 複数スレッドでの並列実行を設定し、ハードウェアの性能を使い切ります。あわせて、テストスイート全体を回し直すのではなく、変更されたコード範囲(Git Diff)をもとにテストを絞り込む Targeted Test Run を取り入れます。
- Audit Sync と Coverage Threshold による整合性と網羅性の管理: ズレを検出する監査ツール(Audit Sync)を定期的に走らせ、プランのファイルと実際のテストケースのシナリオ一覧を突き合わせて、抜けたケースや孤立したケースをその場で見つけます。あわせて、コードを提出するたびにカバレッジの低下を止める Coverage Regression Check を組み合わせ、テストのないコードが混ざるのを防ぎます。
おわりに
手動テストから自動テストへの移行は、仕事の進め方と品質管理の考え方そのものを引き上げていく道のりです。AI の助けでテストコードを書く時間は大きく短縮できますが、プロジェクトが長く成功し続けるかどうかは、しっかりした工程を組み立てられるかにかかっています。層ごとの責任をはっきり分けること、コードに手心を加えさせない安全な境界を設けること、そして関係者にとって見通しのよいレポートの仕組みを保ち続けること。
これらがかみ合ったとき、自動テストスイートは開発のライフサイクル全体を通してソフトウェアの品質を守る、確かな盾になります。
参考資料
- https://www.james-willett.com/the-evolution-of-the-testing-pyramid/
- https://learn.cypress.io/testing-foundations/the-testing-pyramid
- https://nocode.autify.com/blog/top-6-test-automation-challenges
- https://www.datadoghq.com/knowledge-center/flaky-tests/
- https://apidog.com/blog/spec-first-api-development/